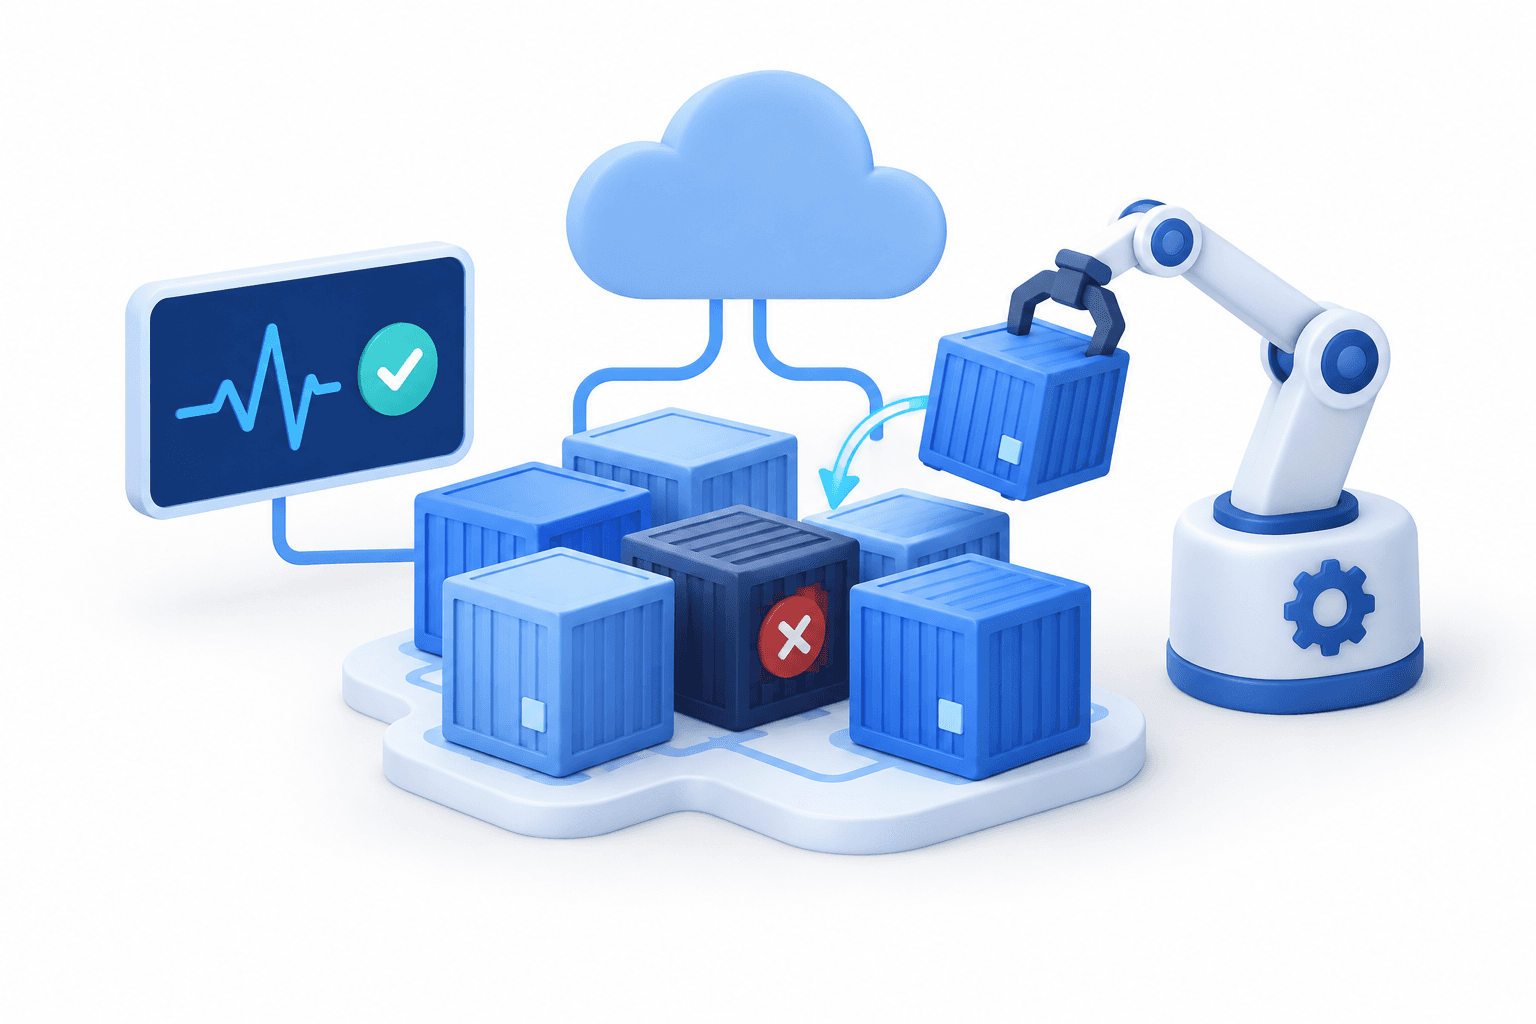
En undersøgelse, som Barmeter Technologies fremhævede den 26. oktober 2026, viste, at en Kubernetes-genoprettelsespolitik baseret på flere signaler løste 96,7 % af de indsprøjtede fejl i kontrollerede forsøg. Resultaterne stammer fra et begrænset testmiljø og dokumenterer ikke ydeevnen i produktionssystemer i stor skala.
Vigtigste pointer
- Forskerne sammenlignede tre driftsmetoder på tværs af 186 uafhængigt tidsmålte forsøg.
- Politikken baseret på flere signaler kombinerede driftstilstand, sundhedstjek af applikationen og fejlhistorik.
- Implementeringen omfattede én node og én tjeneste.
Sådan fungerede Kubernetes-genoprettelsestesten
Undersøgelsen, der blev offentliggjort i august 2026 og havde infrastrukturspecialisten Dinesh Kumar Movva med, anvendte et Kubernetes-kontrolplan og en specialudviklet nodeagent, der forbandt Kubernetes-objekter med Docker-containere.
Forskerne testede seks fejlkategorier: nedbrud i containere, fejl som følge af for lidt hukommelse, mangelfulde udrulninger af applikationer, uhåndterlige fastfrysninger af applikationer, netværkspartitioner og alvorlig CPU-mangel. De sammenlignede fravær af automatisering, en grundlæggende regel om genstart ved nedbrud og en deterministisk politik, der anvendte flere driftssignaler.
Politikken baseret på flere signaler havde den højeste genoprettelsesrate. Undersøgelsen fandt også begrænsninger ved afhjælpning, der kun består i genstart, særligt ved fastfrysninger, netværkspartitioner og fejlslagne udrulninger, hvor endnu en genstart muligvis ikke løser det underliggende problem.
| Punkt | Detaljer |
|---|---|
| Politik baseret på flere signaler | Genoprettede 96,7 % af de indsprøjtede fejl |
| Grundlæggende regel om genstart ved nedbrud | Genoprettede 47,9 % af de indsprøjtede fejl |
| Ingen automatisering | Genoprettede 14,6 % af de indsprøjtede fejl |
Hvad resultaterne viser – og ikke viser
Selvom undersøgelsens titel henviser til AI, er den foreslåede tilgang et gennemskueligt regel- og pointsystem, ikke en trænet maskinlæringsmodel eller en autonom sprogmodelbaseret agent.
Evalueringen anvendte en referenceløsning med én node og én tjeneste i et begrænset miljø. Resultaterne bør ikke betragtes som dokumentation for ydeevne i produktionsmiljøer i stor skala.
Læs flere nyheder
Flere nyheder fra FinanceVelix
Ansvarsfraskrivelse
Denne FinanceVelix-artikel indeholder generelle oplysninger, ikke personlig finansiel, investeringsmæssig, juridisk eller skattemæssig rådgivning. Markedspriser, rentesatser og økonomiske forhold kan ændre sig; investeringer indebærer risiko for tab. Oplysningerne afspejler det materiale, der var tilgængeligt på udgivelsestidspunktet, og kan ændre sig. Kontrollér selv vigtige oplysninger, og rådfør dig med en kvalificeret fagperson efter behov. Omtale af et aktiv, en virksomhed eller en tjeneste er ikke en anbefaling.



Kommentarer
Vis respekt. Ingen spam, udgivelse for at være en anden eller deling af private loginoplysninger. Almindelige opslag og kommentarer vises straks; mistænkelige links tilbageholdes til gennemgang.
Vent venligst...