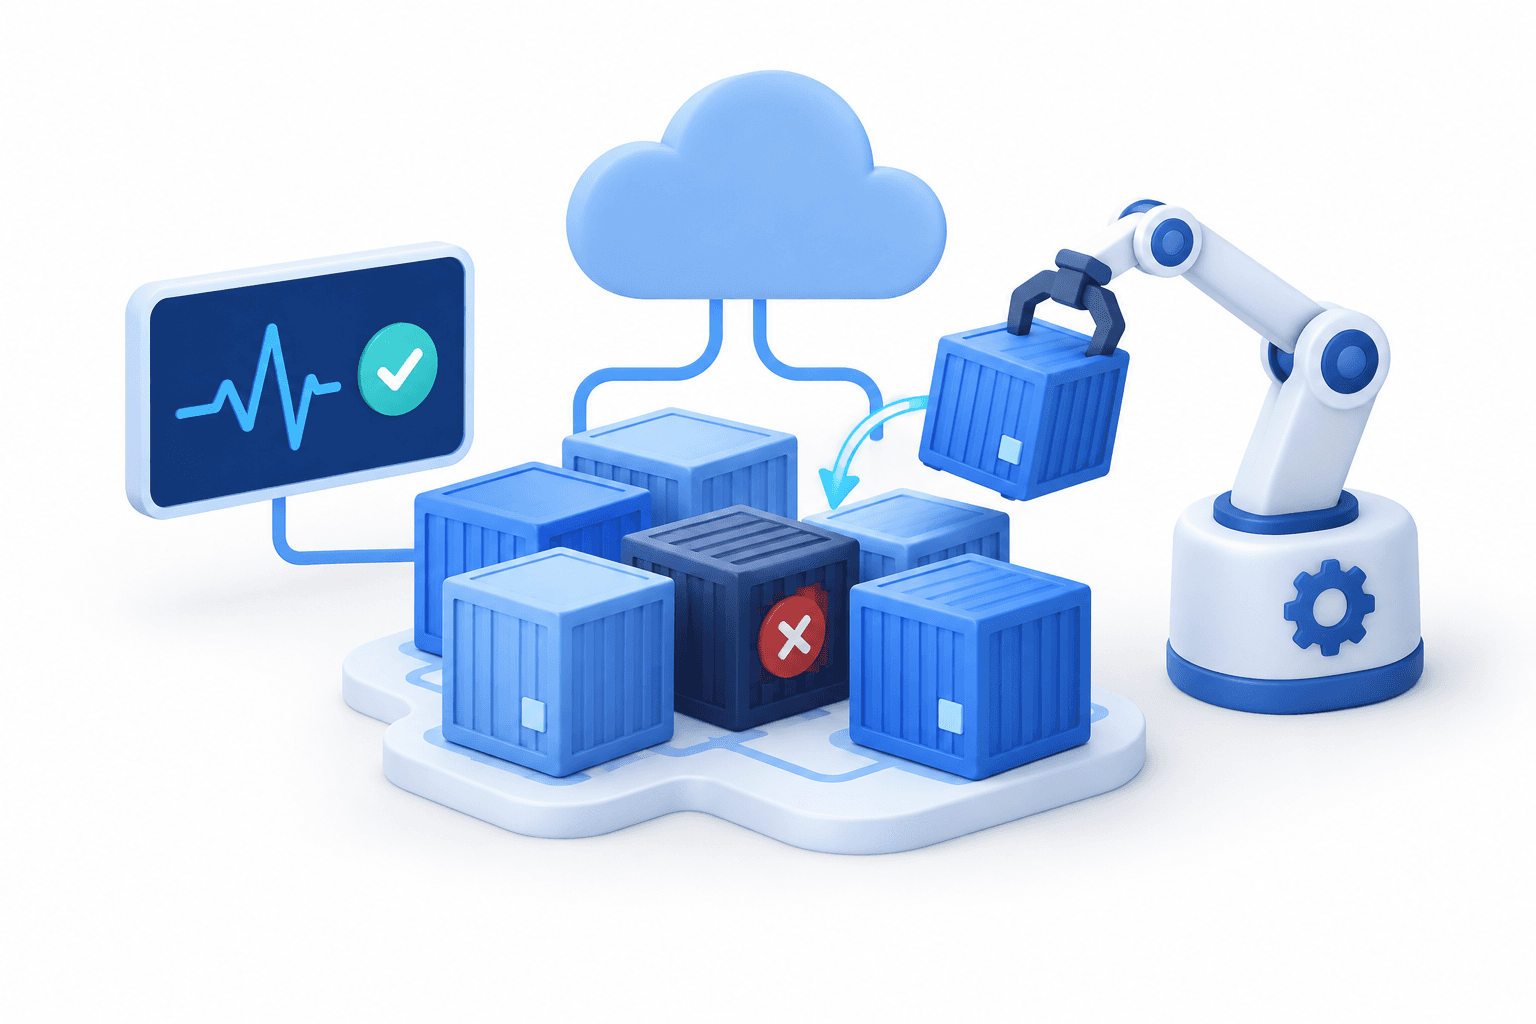
Eine von Barmeter Technologies am 26. Oktober 2026 hervorgehobene Studie ergab, dass eine Kubernetes-Wiederherstellungsrichtlinie mit mehreren Signalen in kontrollierten Versuchen 96,7 % der gezielt ausgelösten Fehler behob. Die Ergebnisse stammen aus einer begrenzten Testumgebung und belegen keine Leistung in Produktionssystemen im großen Maßstab.
Die wichtigsten Erkenntnisse
- Die Forschenden verglichen drei Betriebsansätze in 186 unabhängig zeitlich erfassten Versuchen.
- Die Richtlinie mit mehreren Signalen kombinierte Laufzeitstatus, Anwendungs-Health-Checks und Fehlerhistorie.
- Die Implementierung umfasste einen einzelnen Knoten und einen einzelnen Dienst.
So funktionierte der Kubernetes-Wiederherstellungstest
Die im August 2026 veröffentlichte Studie, an der der Infrastrukturspezialist Dinesh Kumar Movva mitwirkte, nutzte eine Kubernetes-Steuerungsebene und einen speziell entwickelten Knotenagenten, der Kubernetes-Objekte mit Docker-Containern verband.
Die Forschenden testeten sechs Fehlerkategorien: Container-Abstürze, Out-of-Memory-Fehler, fehlerhafte Anwendungs-Rollouts, unbemerkte Anwendungshänger, Netzwerkpartitionen und starke CPU-Auslastung mit Ressourcenmangel. Verglichen wurden der Verzicht auf Automatisierung, eine einfache Regel zum Neustart nach einem Absturz und eine deterministische Richtlinie, die mehrere Betriebssignale nutzt.
Die Richtlinie mit mehreren Signalen erzielte die höchste Wiederherstellungsrate. Die Studie stellte zudem die Grenzen einer reinen Neustartmaßnahme fest, insbesondere bei Hängern, Netzwerkpartitionen und fehlerhaften Deployments, bei denen ein weiterer Neustart das zugrunde liegende Problem möglicherweise nicht behebt.
| Element | Details |
|---|---|
| Richtlinie mit mehreren Signalen | Behob 96,7 % der gezielt ausgelösten Fehler |
| Einfache Neustartregel bei Abstürzen | Behob 47,9 % der gezielt ausgelösten Fehler |
| Keine Automatisierung | Behob 14,6 % der gezielt ausgelösten Fehler |
Was die Ergebnisse zeigen – und was nicht
Trotz des Verweises auf KI im Studientitel handelt es sich beim vorgeschlagenen Ansatz um ein nachvollziehbares Regel- und Bewertungssystem, nicht um ein trainiertes Machine-Learning-Modell oder einen autonomen Sprachmodell-Agenten.
Die Evaluierung nutzte eine Referenzimplementierung mit einem einzelnen Knoten und einem einzelnen Dienst in einer eingeschränkten Umgebung. Die Ergebnisse sollten nicht als validierte Leistung in Produktionsumgebungen im großen Maßstab betrachtet werden.
Weitere Nachrichten lesen
Weitere Nachrichten von FinanceVelix
Haftungsausschluss
Dieser FinanceVelix-Artikel enthält allgemeine Informationen und stellt keine persönliche Finanz-, Anlage-, Rechts- oder Steuerberatung dar. Marktpreise, Zinssätze und wirtschaftliche Bedingungen können sich ändern; Anlagen sind mit Verlustrisiken verbunden. Die Angaben entsprechen dem zum Zeitpunkt der Veröffentlichung verfügbaren Informationsstand und können sich ändern. Prüfen Sie wichtige Informationen eigenständig und wenden Sie sich bei Bedarf an eine qualifizierte Fachperson. Die Erwähnung eines Vermögenswerts, eines Unternehmens oder einer Dienstleistung stellt keine Empfehlung dar.



Kommentare
Seien Sie respektvoll. Kein Spam, kein Auftreten unter fremder Identität und keine privaten Zugangsdaten. Gewöhnliche Beiträge und Kommentare erscheinen sofort; verdächtige Links werden zur Überprüfung zurückgehalten.
Bitte warten Sie...