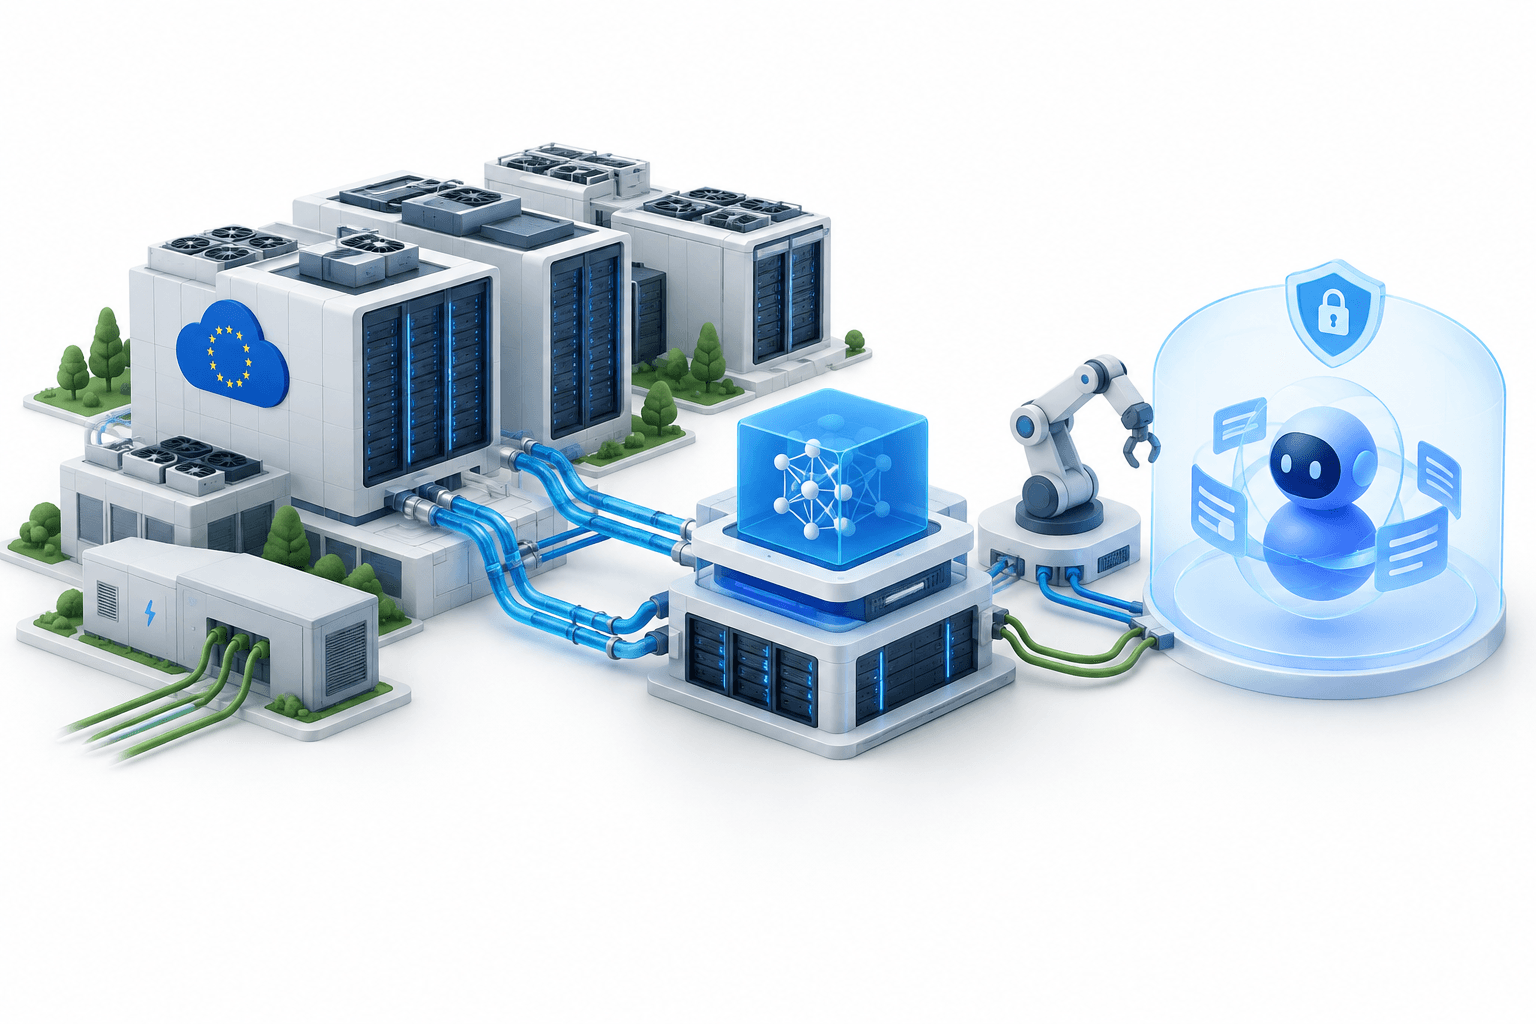
Les clouds européens dédiés à l’IA développent leurs infrastructures de calcul régionales tout en ajoutant des services spécialisés de modèles et des contrôles sur la manière dont les agents d’IA utilisent les outils et les systèmes d’entreprise. Le point sur les partenaires de NVIDIA décrit un ensemble de tests achevés, de services déjà utilisés et de déploiements prévus, notamment les tests d’inférence de Nscale soumis à des contraintes énergétiques, la livraison prévue de Vera Rubin à Mistral en 2027 et le soutien de l’écosystème à l’OpenShell Reference Architecture.
Principaux points à retenir
- Nscale a fait état de tests permettant d’utiliser 37 % de GPU supplémentaires et d’accroître de près de 50 % le débit agrégé d’inférence dans le cadre du même budget de puissance provisionné.
- Les partenaires associent des infrastructures régionales à des services spécialisés, notamment le modèle de routage de révision de code de CodeRabbit et la plateforme de robotique de Nebius.
- Les partisans d’OpenShell visent à définir des limites d’accès des agents dans les logiciels et le matériel ; le soutien des partenaires ne constitue pas un déploiement client achevé.
Sommaire
- Les clouds européens dédiés à l’IA se heurtent à la contrainte énergétique
- Qu’est-ce qui est disponible, testé ou encore prévu ?
- Des services spécialisés mettent les capacités régionales à profit
- Les contrôles des agents couvrent les logiciels et le matériel
- Conclusion
Les clouds européens dédiés à l’IA se heurtent à la contrainte énergétique
Cette expansion ne consiste pas simplement à installer davantage d’équipements informatiques. NVIDIA considère l’énergie comme une contrainte à mesure que les usines d’IA se développent, ce qui fait de la quantité de travail utile réalisée dans le cadre d’une allocation électrique existante un élément important de la planification des capacités.
Les tests rapportés par Nscale en donnent un exemple concret. À l’aide de systèmes NVIDIA GB300 NVL72, l’entreprise a démontré que DSX MaxLPS permettait d’utiliser 37 % de GPU supplémentaires et d’accroître de près de 50 % le débit agrégé d’inférence dans le cadre du même budget de puissance provisionné. Ces résultats décrivent une configuration de test, et non une amélioration mesurée dans l’ensemble des installations de Nscale.
Nscale prévoit également de déployer une infrastructure Vera Rubin pour l’entraînement de modèles de pointe et les charges de travail de production, parallèlement à son expansion sur cinq marchés européens. De son côté, Crusoe développe Spark, une conception modulaire d’usine d’IA refroidie par liquide pour la plateforme Vera Rubin, destinée à rapprocher les capacités d’inférence des utilisateurs.
La portée géographique dépasse l’Europe. NVIDIA cite également le développement et l’expansion d’infrastructures dans les pays nordiques, en Afrique et en Asie centrale par des partenaires tels qu’Aleria, Cassava Technologies, Firebird, G42, Radiant, SWI Compute et Vultr.
| Élément | Détails |
|---|---|
| Tests d’efficacité énergétique de Nscale | 37 % de GPU supplémentaires et près de 50 % de hausse du débit agrégé d’inférence signalés dans le cadre du même budget de puissance provisionné avec DSX MaxLPS. |
| Infrastructure de Mistral | La livraison de Vera Rubin est prévue pour 2027 ; Mistral Large 4 a été entraîné sur 3 800 GPU Grace Blackwell dans des centres de données européens exploités par Mistral. |
| Modèle de routage de CodeRabbit | Le taux d’accord du routage est passé de 75,8 % à 80,7 %, tandis que les coûts d’inférence estimés ont diminué de 50 % pour la charge de travail évaluée. |
| Agents de vente au détail de Nebius | Des plans portant sur les stocks, les opérations en magasin et le réglage fin ont été lancés en accès anticipé. |
| OpenShell Reference Architecture | Annoncée au GTC Berlin avec le soutien de partenaires ; conçue pour coordonner les limites des agents entre les logiciels d’exécution, les CPU et les DPU. |
Qu’est-ce qui est disponible, testé ou encore prévu ?
Le rapport de NVIDIA sur les partenaires de cloud régionaux et les contrôles des agents regroupe plusieurs stades d’activité distincts. Il est important de les différencier : un modèle déjà en production, un service en accès anticipé et une future livraison de matériel n’offrent pas la même disponibilité immédiate aux clients.
L’expansion de Mistral illustre cette distinction. La livraison de son infrastructure Vera Rubin est prévue pour 2027. Séparément, NVIDIA indique que Mistral Large 4 a été entraîné sur 3 800 GPU Grace Blackwell dans des centres de données européens exploités par Mistral. Le travail sur le modèle est présenté comme achevé, tandis que la prochaine livraison d’infrastructure reste à venir.
Verda prévoit également de déployer Vera Rubin, mais ses modèles à poids ouverts NVIDIA Nemotron et Cosmos sont déjà en production. L’entreprise utilise aussi le cadre open source Dynamo pour optimiser l’inférence.
Des services spécialisés mettent les capacités régionales à profit
Pour les développeurs, la question pratique est de savoir ce que permet cette infrastructure supplémentaire. Le point sur les partenaires met en avant la révision de code, la robotique, les agents de vente au détail et les services de modèles d’entreprise, au lieu de présenter les seules capacités de calcul comme un produit fini.
Baseten a développé pour CodeRabbit un modèle spécialisé de routage de révision de code à l’aide de Nemotron 3.5 Lightning. Après un réglage fin supervisé et un apprentissage par renforcement, le taux d’accord du routage est passé de 75,8 % à 80,7 %, tandis que les coûts d’inférence estimés ont baissé de 50 % pour la charge de travail évaluée. Ce chiffre de coût est une estimation liée à cette charge de travail, et non une réduction générale pour tous les usages de modèles.
Nebius a adopté NVIDIA Groq 3 LPX et utilise le réseau Ethernet Spectrum-X pour l’intégrer à Vera Rubin NVL72 sur sa plateforme Token Factory. Selon NVIDIA, cette combinaison accélérera la génération de jetons pour les applications sensibles à la latence et les systèmes agentiques, grâce à des points de terminaison gérés sans serveur et dédiés.
Nebius propose également un Physical AI Workbench utilisé par des entreprises de robotique, notamment Rhoda AI, RoboForce et Sereact. Ses plans d’agents de vente au détail NVIDIA, consacrés aux stocks, aux opérations en magasin et au réglage fin, sont entrés en accès anticipé.
Fireworks et Era4 adoptent une autre approche : associer des services d’entraînement et d’inférence de modèles à des capacités Blackwell Ultra à refroidissement liquide directement installées dans le centre d’Era4 à Chesterfield. Leur partenariat soutient des projets d’applications d’entreprise dans les services financiers, l’assurance et les sciences de la vie.
Les contrôles des agents couvrent les logiciels et le matériel
Connecter des modèles d’IA aux outils d’entreprise crée un besoin distinct de celui consistant à fournir une puissance de calcul suffisante : les organisations doivent définir et faire respecter les limites de ce à quoi les agents peuvent accéder et de ce qu’ils peuvent faire. Annoncée au GTC Berlin, l’OpenShell Reference Architecture est conçue pour répondre à ces enjeux à tous les niveaux de la pile de déploiement.
L’architecture attribue des fonctions distinctes à ses composants. Vera Rubin NVL72 assure l’inférence des modèles ; les CPU Vera avec OpenShell prennent en charge les environnements d’agents et l’utilisation des outils ; et les DPU BlueField-4 exécutant NVIDIA Sentry assurent l’application des règles au niveau du silicium. Le logiciel d’exécution sécurisé OpenShell constitue le socle de l’architecture.
Parmi les partenaires qui la soutiennent figurent des fournisseurs de services cloud et de modèles tels que Baseten, CoreWeave, Crusoe, DigitalOcean, Fireworks, Nebius, Nscale et Vultr. Le rapport décrit un soutien de l’écosystème destiné à permettre des déploiements sécurisés d’agents ; il ne fait pas état d’un déploiement achevé chez chacun des partenaires cités.
Conclusion
Cette mise à jour relie les investissements dans le calcul régional à des charges de travail spécifiques et à des contrôles d’accès des agents. Les éléments les plus probants sont les tests mesurés et les services déjà utilisés ; les déploiements prévus de Vera Rubin et l’adoption plus large d’OpenShell constituent l’étape suivante, et non des capacités déjà mises en place.
Lire d’autres actualités
Plus d’actualités FinanceVelix
Avertissement
Cet article de FinanceVelix fournit des informations générales et ne constitue pas un conseil financier, d’investissement, juridique ou fiscal personnalisé. Les cours du marché, les taux d’intérêt et la conjoncture économique peuvent évoluer ; les investissements comportent un risque de perte. Les faits reflètent les informations disponibles au moment de la publication et peuvent changer. Vérifiez de manière indépendante les informations importantes et consultez un professionnel qualifié si nécessaire. La mention d’un actif, d’une entreprise ou d’un service ne constitue pas une recommandation.



