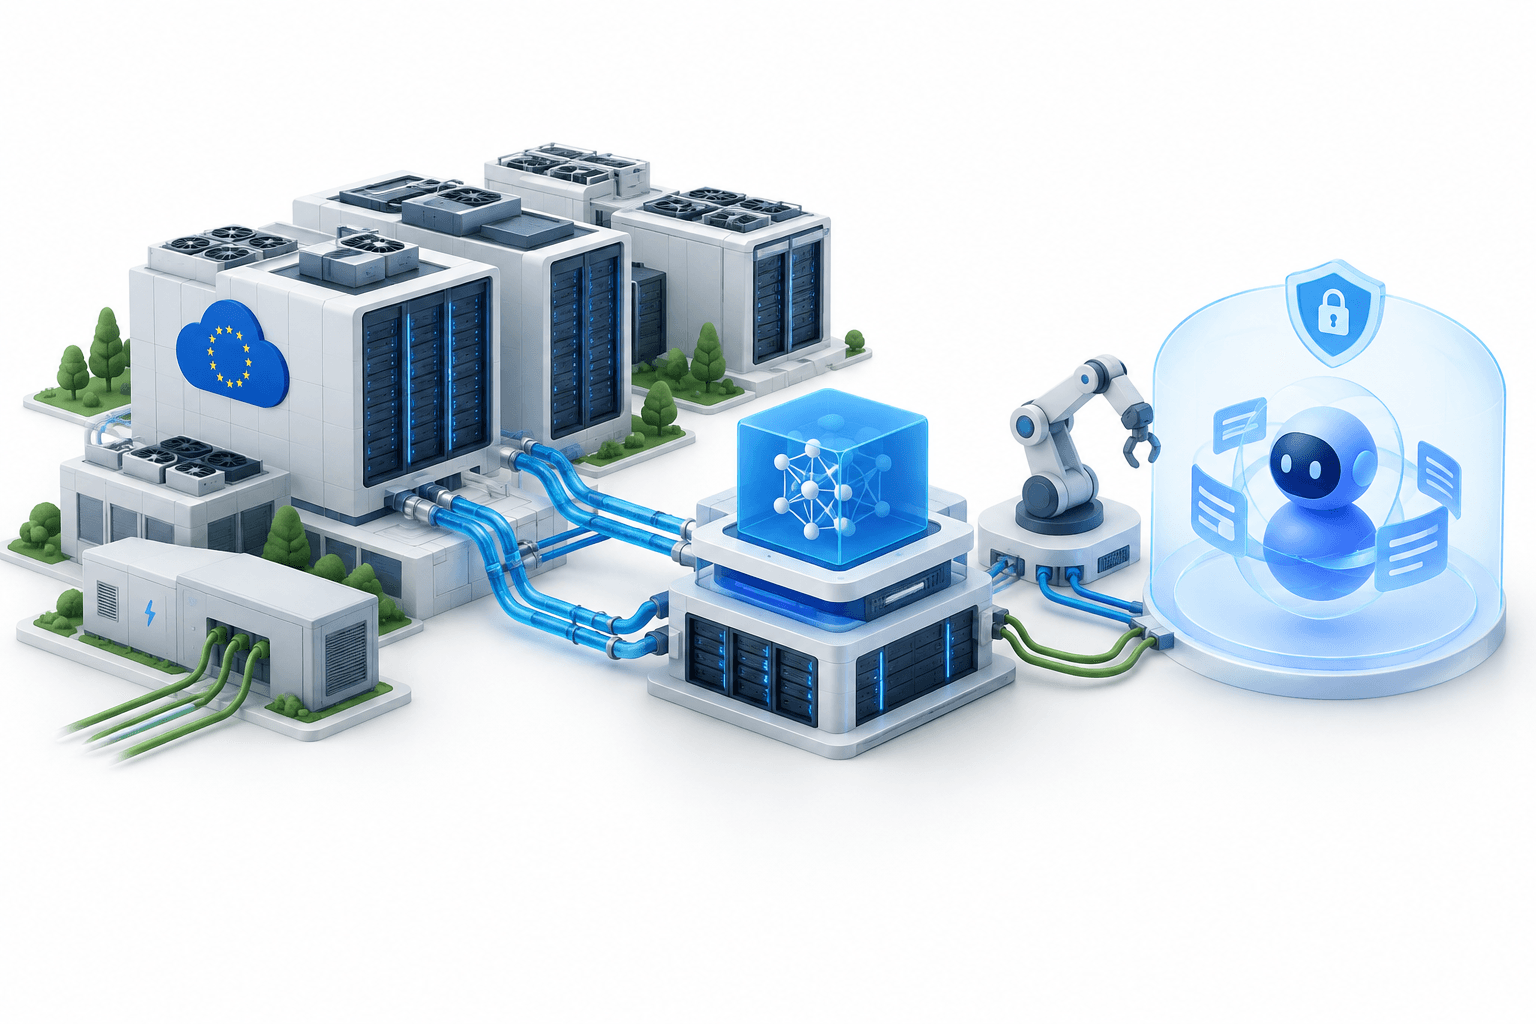
Europejskie chmury AI rozbudowują regionalną infrastrukturę obliczeniową, jednocześnie dodając wyspecjalizowane usługi modelowe i mechanizmy kontroli tego, w jaki sposób agenci AI korzystają z narzędzi i systemów biznesowych. Aktualizacja partnerów NVIDIA opisuje połączenie zakończonych testów, już dostępnych usług i planowanych wdrożeń, w tym testów wnioskowania Nscale przy ograniczonej dostępności energii, planowanej dostawy Vera Rubin dla Mistral w 2027 roku oraz wsparcia ekosystemu dla OpenShell Reference Architecture.
Najważniejsze informacje
- Nscale poinformowała o testach, które pozwoliły uruchomić o 37% więcej procesorów GPU i osiągnąć niemal o 50% wyższą łączną przepustowość wnioskowania przy tym samym przydzielonym budżecie mocy.
- Partnerzy łączą regionalną infrastrukturę z wyspecjalizowanymi usługami, w tym modelem kierowania zadań do przeglądu kodu CodeRabbit i platformą robotyczną Nebius.
- Podmioty wspierające OpenShell dążą do ustanowienia granic dostępu agentów w oprogramowaniu i sprzęcie; wsparcie partnera nie jest równoznaczne z zakończonym wdrożeniem u klienta.
Spis treści
- Europejskie chmury AI mierzą się z ograniczeniami energetycznymi
- Co jest dostępne, przetestowane lub nadal planowane?
- Wyspecjalizowane usługi wykorzystują regionalne moce obliczeniowe
- Kontrola agentów obejmuje oprogramowanie i sprzęt
- Wnioski
Europejskie chmury AI mierzą się z ograniczeniami energetycznymi
Rozbudowa nie polega wyłącznie na instalowaniu większej liczby urządzeń obliczeniowych. NVIDIA wskazuje, że wraz z rozwojem fabryk AI ograniczeniem staje się dostępność energii, dlatego ważnym elementem planowania mocy obliczeniowych jest ilość użytecznej pracy, którą można wykonać w ramach istniejącego przydziału energii elektrycznej.
Raportowane testy Nscale stanowią konkretny przykład. Z wykorzystaniem systemów NVIDIA GB300 NVL72 firma wykazała, że DSX MaxLPS umożliwił uruchomienie o 37% więcej procesorów GPU i osiągnięcie niemal o 50% wyższej łącznej przepustowości wnioskowania przy tym samym przydzielonym budżecie mocy. Wyniki te dotyczą konfiguracji testowej, a nie zmierzonej poprawy we wszystkich obiektach Nscale.
Nscale planuje również wdrożyć infrastrukturę Vera Rubin do trenowania modeli czołowej klasy i obsługi obciążeń produkcyjnych, a także rozszerzyć działalność na pięć europejskich rynków. Z kolei Crusoe opracowuje Spark — modułową, chłodzoną cieczą konstrukcję fabryki AI dla platformy Vera Rubin, która ma przybliżyć moc obliczeniową do wnioskowania użytkownikom.
Zasięg geograficzny wykracza poza Europę. NVIDIA wskazuje również na rozwój i rozbudowę infrastruktury w krajach nordyckich, Afryce i Azji Środkowej przez partnerów, wśród których są Aleria, Cassava Technologies, Firebird, G42, Radiant, SWI Compute i Vultr.
| Element | Szczegóły |
|---|---|
| Testy efektywności energetycznej Nscale | Przy użyciu DSX MaxLPS odnotowano o 37% więcej procesorów GPU i niemal o 50% wyższą łączną przepustowość wnioskowania przy tym samym przydzielonym budżecie mocy. |
| Infrastruktura Mistral | Dostawa Vera Rubin jest planowana na 2027 rok; Mistral Large 4 wytrenowano na 3 800 procesorach GPU Grace Blackwell w europejskich centrach danych obsługiwanych przez Mistral. |
| Model kierowania zadań CodeRabbit | Wskaźnik zgodności kierowania wzrósł z 75,8% do 80,7%, a szacowane koszty wnioskowania dla ocenianego obciążenia spadły o 50%. |
| Agenci do handlu detalicznego Nebius | Plany wdrożeniowe obejmujące zarządzanie zapasami, operacje sklepowe i dostrajanie modeli udostępniono w ramach wczesnego dostępu. |
| OpenShell Reference Architecture | Ogłoszona podczas GTC Berlin i wspierana przez partnerów; ma koordynować granice działania agentów w oprogramowaniu uruchomieniowym, procesorach CPU i DPU. |
Co jest dostępne, przetestowane lub nadal planowane?
Raport NVIDIA dotyczący regionalnych partnerów chmurowych i kontroli agentów łączy ze sobą kilka różnych etapów działalności. Warto je rozróżniać: model już działający w środowisku produkcyjnym, usługa we wczesnym dostępie i przyszła dostawa sprzętu nie oznaczają takiej samej natychmiastowej dostępności dla klientów.
Rozwój Mistral pokazuje tę różnicę. Dostawa infrastruktury Vera Rubin jest planowana na 2027 rok. NVIDIA informuje osobno, że Mistral Large 4 wytrenowano na 3 800 procesorach GPU Grace Blackwell w europejskich centrach danych obsługiwanych przez Mistral. Prace nad modelem są opisane jako zakończone, natomiast kolejna dostawa infrastruktury dopiero nastąpi.
Verda również planuje wdrożyć Vera Rubin, ale już teraz wykorzystuje otwarte modele o wagach udostępnionych przez NVIDIA Nemotron i Cosmos w środowisku produkcyjnym. Korzysta także z frameworka open source Dynamo do optymalizacji wnioskowania.
Wyspecjalizowane usługi wykorzystują regionalne moce obliczeniowe
Dla programistów praktyczne pytanie brzmi: czemu służy dodatkowa infrastruktura? Aktualizacja partnerów wskazuje na przegląd kodu, robotykę, agentów do handlu detalicznego i usługi modeli dla przedsiębiorstw, zamiast przedstawiać samą moc obliczeniową jako gotowy produkt.
Baseten opracował dla CodeRabbit wyspecjalizowany model kierowania zadań do przeglądu kodu, wykorzystując Nemotron 3.5 Lightning. Po dostrojeniu nadzorowanym i uczeniu przez wzmacnianie zgodność kierowania poprawiła się z 75,8% do 80,7%, a szacowane koszty wnioskowania dla ocenianego obciążenia spadły o 50%. Wartość dotycząca kosztów jest szacunkiem związanym z tym obciążeniem, a nie ogólną redukcją kosztów korzystania ze wszystkich modeli.
Nebius wdrożyło NVIDIA Groq 3 LPX, wykorzystując sieć Spectrum-X Ethernet do integracji tego rozwiązania z Vera Rubin NVL72 na swojej platformie Token Factory. Według NVIDIA połączenie to przyspieszy generowanie tokenów w aplikacjach wrażliwych na opóźnienia i systemach agentowych za pośrednictwem zarządzanych bezserwerowych punktów końcowych oraz dedykowanych punktów końcowych.
Nebius oferuje również Physical AI Workbench, z którego korzystają firmy robotyczne, w tym Rhoda AI, RoboForce i Sereact. Plany wdrożeniowe NVIDIA dla agentów handlu detalicznego, obejmujące zarządzanie zapasami, operacje sklepowe i dostrajanie modeli, są już dostępne we wczesnym dostępie.
Fireworks i Era4 wybrały inną drogę: łączą usługi trenowania modeli i wnioskowania z bezpośrednim dostępem do chłodzonych cieczą zasobów Blackwell Ultra w obiekcie Era4 w Chesterfield. Ich partnerstwo wspiera plany dotyczące zastosowań dla przedsiębiorstw w usługach finansowych, ubezpieczeniach i naukach przyrodniczych.
Kontrola agentów obejmuje oprogramowanie i sprzęt
Połączenie modeli AI z narzędziami biznesowymi wiąże się z odrębnym wymogiem, niezależnym od zapewnienia wystarczającej mocy obliczeniowej: organizacje muszą określić i egzekwować zakres dostępu agentów oraz dozwolone działania. Ogłoszona podczas GTC Berlin architektura OpenShell Reference Architecture ma wyznaczać te granice w całym stosie wdrożeniowym.
Architektura przypisuje poszczególnym komponentom odrębne funkcje. Vera Rubin NVL72 obsługuje wnioskowanie modelu; procesory Vera CPU z obsługą OpenShell wspierają mechanizmy działania agentów i korzystanie z narzędzi; a procesory DPU BlueField-4 z uruchomionym NVIDIA Sentry egzekwują ograniczenia na poziomie krzemu. Podstawą architektury jest bezpieczne oprogramowanie uruchomieniowe OpenShell.
Wśród podmiotów wspierających są dostawcy usług chmurowych i usług modelowych, tacy jak Baseten, CoreWeave, Crusoe, DigitalOcean, Fireworks, Nebius, Nscale i Vultr. Raport opisuje wsparcie ekosystemu, którego celem jest umożliwienie bezpiecznych wdrożeń agentów, a nie zakończone wdrożenie u każdego wymienionego partnera.
Wnioski
Aktualizacja łączy inwestycje w regionalne zasoby obliczeniowe z konkretnymi obciążeniami i mechanizmami kontroli dostępu agentów. Najmocniejsze potwierdzenie stanowią zmierzone wyniki testów i usługi już wykorzystywane w praktyce; planowane wdrożenia Vera Rubin i szersze przyjęcie OpenShell to kolejny etap, a nie już ukończona rozbudowa mocy.
Więcej wiadomości
Więcej wiadomości FinanceVelix
Zastrzeżenie
Ten artykuł FinanceVelix zawiera ogólne informacje i nie stanowi spersonalizowanej porady finansowej, inwestycyjnej, prawnej ani podatkowej. Ceny rynkowe, stopy procentowe i warunki gospodarcze mogą się zmieniać; inwestycje wiążą się z ryzykiem straty. Fakty odzwierciedlają materiały dostępne w chwili publikacji i mogą ulec zmianie. Ważne informacje należy weryfikować samodzielnie, a w razie potrzeby skonsultować się z wykwalifikowanym specjalistą. Wzmianka o aktywach, firmie lub usłudze nie stanowi rekomendacji.



